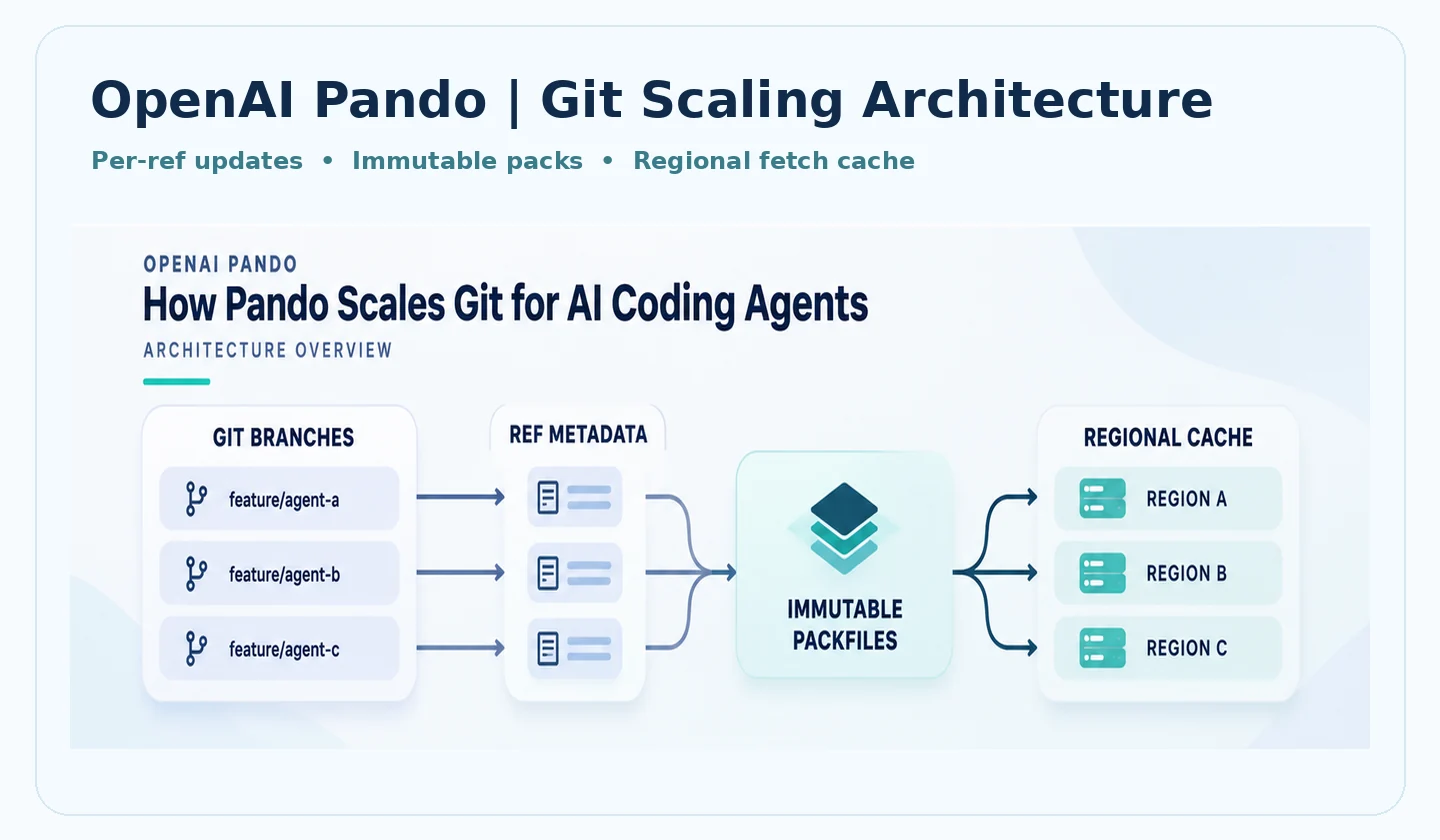
여러 AI 코딩 에이전트가 같은 모노레포에서 작업한다고 가정해 보자. 한 에이전트는 기능을 수정하고, 다른 에이전트는 테스트를 보강한다. 각자 별도 브랜치로 작업하므로 코드 충돌은 줄어든다. 그런데 에이전트들이 거의 동시에 git push와 git fetch를 반복하면, 병목은 코드가 아니라 Git 서버에서 발생할 수 있다.
2026년 11월 2일 OpenAI가 공개한 Scaling Git at OpenAI는 이 문제를 다룬 엔지니어링 사례다. OpenAI는 내부 모노레포의 대규모 에이전트 작업을 지원하기 위해 Git과 호환되는 새 백엔드 Pando를 만들었다.
이 글의 핵심은 ‘Git을 버렸다’가 아니다. Git의 클라이언트와 데이터 형식을 유지하면서, 서버가 참조 정보를 관리하고 객체를 전달하는 방법을 바꿨다는 점이다.
브랜치를 나눴는데도 Git 서버가 느려지는 이유
여러 에이전트가 서로 다른 파일을 수정하면 병렬 개발이 쉬워진다. 그러나 Git 서버는 파일 충돌 외에도 저장소 전체의 참조 정보와 객체 전송을 처리한다.
refs/heads/feature-a와 refs/heads/feature-b는 서로 다른 브랜치다. 클라이언트는 push 중에 ref를 업데이트하며, fetch나 clone에서는 자신에게 없는 커밋·트리·블롭 객체를 packfile로 받는다. Git pack protocol은 이 데이터 교환의 기반이다.
문제는 서버 구현 방식에 따라 서로 무관한 브랜치 업데이트도 전역 단위의 락·일관성 관리와 충돌할 수 있다는 점이다. 클라이언트마다 필요한 객체를 새로 계산하고 pack을 만들면 CPU와 I/O 부담도 커진다. 사람 몇 명이 하루에 여러 번 push하는 저장소와 수천 개 작업자가 반복해서 브랜치를 만들고 가져오는 저장소는 부하 패턴이 다르다.
| 작업 | 소수 개발자 저장소 | 다중 AI 에이전트 저장소 |
|---|---|---|
| 브랜치 생성 | 드문 이벤트 | 작업·시도마다 빈번할 수 있음 |
| push | 사람이 편집 완료 후 실행 | 독립 작업 종료 시점에 집중 |
| fetch | 사람의 주기적 동기화 | 새로운 실행 환경마다 반복 |
| ref 조회 | 비교적 적은 참조 목록 | 많은 단기 브랜치와 메타데이터 |
| pack 생성 | 대체로 감당 가능한 빈도 | 동시 계산이 서버 자원 압박 |
이 표는 Pando의 공식 측정치가 아니라 부하 특성을 이해하기 위한 비교다. 기존 Git 구현이 반드시 이런 문제를 가진다는 주장도 아니다. 실제 병목은 사용하는 서버, 프로토콜, 캐시, 저장소 구조에 따라 달라진다.
Pando가 바꾼 첫 번째 계약: 전체 ref보다 개별 ref
일반적인 Git 사용자는 같은 시점에 저장소의 모든 브랜치가 일관된 한 묶음으로 보인다고 기대하기 쉽다. 서버가 이 전체 상태의 원자적 스냅샷을 유지하도록 설계하면 동시 업데이트의 직렬화 비용이 발생할 수 있다.
Pando는 OpenAI가 설명한 바에 따르면 저장소 전역 참조의 강한 동시 일관성을 완화하고, 개별 ref 업데이트에는 직렬화 가능한 의미를 유지한다. 다시 말해 같은 브랜치 포인터를 동시에 변경하려는 두 요청은 충돌 검사를 받아야 하지만, 별개의 브랜치까지 한 번에 잠글 필요는 없도록 설계한다.
| 일관성 범위 | Pando의 접근 | 트레이드오프 |
|---|---|---|
| 단일 ref | 경쟁하는 업데이트를 순서화 | 동일 브랜치의 변경 안전성 |
| 저장소 전체 ref 집합 | 인과관계가 성립하는 가시성 모델 | 여러 브랜치를 읽는 순간 완전한 동시 스냅샷이 아닐 수 있음 |
| 불변 Git 객체 | 콘텐츠 기반 객체를 저장·조회 | 객체와 ref의 공개 시점을 조정해야 함 |
여기서 인과적 일관성(causal consistency)은 단순한 ‘언젠가 모두 맞아진다’와 구별해야 한다. 한 변경이 다른 변경에 의존한다면, 뒤의 변경을 보면서 원인이 된 앞의 변경을 모르는 상황은 피하도록 관계를 관리한다. 반면 독립적인 ref들에 대해서는 하나의 전역 총순서를 강제하지 않는다.
이 설계는 Git 클라이언트의 일반적인 단일 브랜치 push/fetch 경로에 적합한 타협이다. 하지만 저장소의 모든 ref가 반드시 같은 순간의 스냅샷이라고 가정하는 운영 도구라면 별도의 검증이 필요하다.
두 번째 계약: 이미 받은 packfile을 다시 사용한다
Git 서버에서 clone·fetch를 처리하는 방법에는 클라이언트가 원하는 객체 집합을 계산해 맞춤형 packfile을 생성하는 방식이 있다. 델타 압축과 객체 선정은 유용하지만 요청이 매우 많으면 비싼 계산이 반복된다.
Pando는 push로 들어온 불변 pack을 저장하고 이를 이후 fetch에 재사용하도록 설계했다. 새로운 요청이 들어올 때마다 같은 객체를 처음부터 다시 압축하는 일을 줄인다.
독자는 데이터 경로를 세 단계로 이해하면 된다.
- 에이전트가 push로 변경 객체와 ref 업데이트 요청을 보낸다. 수신한 pack은 불변 객체 저장 영역에 기록된다.
- 서버는 어떤 ref 버전에서 어떤 pack이 필요한지를 메타데이터로 연결한다. ref 변경과 불변 파일 저장을 같은 방식으로 처리하지 않는다.
- fetch 요청에는 이미 저장된 pack을 가능한 한 재사용하여 전달한다. 캐시가 같은 pack을 여러 클라이언트에 재공급할 수 있다.
OpenAI 설명에 따르면 Pando는 Git packfile-uri 기능만으로 pack을 별도 주소에서 내려받게 하며, Git 응답에는 빈 inline packfile을 보낸다. 이는 Git 클라이언트를 폐기하지 않고 전송 경로를 바꾸는 접근이다.
불변 데이터는 캐시하기 쉽다. 같은 pack URL로 수많은 요청이 들어와도 URL과 콘텐츠가 안정적이면 CDN이나 지역 캐시에 올라간 바이트를 재사용할 수 있다. 브랜치 헤드처럼 계속 바뀌는 작은 메타데이터와 대용량 불변 객체를 분리한 것이 핵심이다.
세 번째 계약: ref 광고량을 줄이고 필요한 것만 전송한다
Pando 글은 클라이언트가 처음 접속할 때 서버가 광고하는 참조 목록도 최적화 대상이라고 설명한다. 방대한 브랜치·내부 ref가 모두 초기 응답에 포함되면 객체 다운로드를 시작하기 전부터 불필요한 메타데이터를 주고받는다.
OpenAI는 기본적으로 trunk 중심의 제한된 ref 정보를 제공하는 전략을 소개한다. 특정 브랜치가 필요한 클라이언트는 해당 ref를 요청할 수 있다. 이는 Git protocol v2와 함께 이해하면 좋다.
여기서 주의할 점은 ‘모든 Git 저장소에서 브랜치를 숨겨야 한다’는 결론으로 뛰지 않는 것이다. 브랜치를 검색하거나 전체 참조 목록에 의존하는 CI, 리뷰 도구, 관리 스크립트가 있다면 선택적 광고가 운영 계약에 어떤 영향을 주는지 확인해야 한다.
pack 재사용만으로 해결되지 않는 부분: 압축과 정리
받은 pack을 그대로 계속 쌓기만 하면 읽어야 할 파일과 인덱스가 늘어난다. 처음에는 push가 빨라도 오래 운영할수록 fetch가 비효율적일 수 있다.
Pando는 pack 목록과 참조 버전을 관리하는 메타데이터, 그리고 여러 작은 pack을 더 큰 버전 범위의 cover로 재구성하는 compaction 계층을 둔다. OpenAI의 기술 글은 L0에서 L4까지의 단계적 정리 방식을 설명한다.
이 개념은 LSM-tree에서 작은 변경을 먼저 빠르게 받았다가, 뒤에서 병합해 읽기 비용을 통제하는 접근과 비슷하다. 다만 Pando와 LSM 기반 데이터베이스를 동일한 구현이라고 단정해서는 안 된다. 비유의 핵심은 동기식 쓰기 경로에서 무거운 재압축을 떼어내는 일이다.
비용은 사라지지 않는다. 쓰기 지연을 낮춘 대신 백그라운드 병합, 인덱스 유지와 추가 저장 공간을 운영해야 한다. OpenAI는 일반 Git 서버와 달리 모든 레벨의 packfile을 유지하며 폐기하거나 가비지 컬렉션으로 제거하지 않는다고 명시한다. 결국 Pando는 복잡성을 없앤 설계라기보다 대규모 요청 환경에서 계산 시점을 바꾸고 역할을 나눈 설계다.
OpenAI가 제시한 성능 수치를 읽는 방법
OpenAI는 Pando 운영에서 중앙값 push 지연을 기존 대비 약 80% 낮췄다고 발표했다. 또한 지역 캐시 적중률이 99%를 넘었고, 한 시간 동안 57TB의 Git pack 데이터를 전달한 사례를 제시했다.
| OpenAI가 공개한 지표 | 해석할 수 있는 범위 | 해석하면 안 되는 범위 |
|---|---|---|
| 중앙값 push 지연 약 80% 감소 | 해당 운영 환경과 이전 구성 대비 개선 | 내 프로젝트도 항상 5배 빨라짐 |
| 지역 캐시 적중률 99% 이상 | 불변 pack 재사용 경로가 높은 적중률 기록 | 모든 Git fetch 요청의 일반적 수치 |
| 1시간 57TB 전달 | 대규모 객체 전송 부하를 처리한 사례 | 단일 클라이언트 속도 보장 |
| 약 1PB/일 수준의 전송 | 전체 처리량 규모 설명 | 전체 데이터가 매일 새로 작성된다는 뜻 |
이 수치는 OpenAI 공식 엔지니어링 게시글에 근거한 자사 보고다. 테스트 워크로드를 독립적으로 동일하게 재현한 외부 벤치마크로 취급하면 안 된다.
또한 중앙값 지연이 낮아졌다고 p99 지연, 최악의 충돌 상황, 장애 복구 시간이 같은 비율로 개선됐다고 판단할 수 없다. 인프라 채택을 검토한다면 해당 분포와 복구 절차까지 별도로 관찰해야 한다.
보통 개발팀은 Pando 대신 무엇을 먼저 적용해야 하나
Pando의 아이디어를 살릴 수 있다고 해서 별도 Git 백엔드를 만드는 것이 합리적인 것은 아니다. 대규모 서버 구현과 일상적인 병렬 코딩 작업을 분리해야 한다.
개발자 2명과 AI 에이전트 여러 개로 구성된 팀이라면 다음 문제가 더 먼저 나타날 수 있다. 에이전트가 같은 파일을 수정해 충돌하거나, 공용 테스트 데이터를 바꾸거나, 여러 프로세스가 같은 node_modules, 포트, 실행 로그를 오염시키는 경우다.
첫 번째 조치는 작업 경계를 만드는 것이다. Git에는 이미 여러 작업 디렉터리와 브랜치를 유지하는 worktree가 있다.
git worktree add ../feature-agent-a -b feature/agent-agit worktree add ../feature-agent-b -b feature/agent-bgit worktree list이 명령은 서로 다른 작업 폴더를 생성하는 기본 예제다. 각 작업 폴더에 별도 실행 포트, 테스트 데이터, 로그와 세션을 연결해야 실제 격리 효과를 얻는다. 같은 폴더에서 두 에이전트가 자유롭게 수정하도록 허용하는 것과는 다르다.
작업이 끝나면 테스트를 통과한 변경만 순서대로 통합한다. CI가 느리다면 우선 대규모 테스트를 샤딩하거나 초기 clone 부담을 줄이는 sparse-checkout, 필요한 범위만 가져오는 방식을 검토한다. 작업당 불필요한 fetch 횟수를 줄이는 것이 새로운 Git 서버를 구축하는 것보다 유리할 가능성이 크다.
Pando가 필요한 상황은 그 다음이다. 이미 독립 브랜치와 실행 환경이 격리돼 있는데도, 저장소 호스팅 자체에서 ref 충돌·pack 생성·네트워크 전송이 핵심 병목으로 확인될 때다. 무엇이 느린지 측정하지 않은 상태에서 아키텍처부터 바꾸면 성능 이익보다 운영 비용이 더 커질 수 있다.
Git 대체가 아니라 에이전트 시대의 저장소 서버 설계
Pando는 Git이 더 이상 필요 없다는 사례가 아니다. 클라이언트와 익숙한 변경 이력 모델을 유지하면서 서버가 refs와 Git 객체를 다루는 방법을 재설계한 사례다.
특히 개별 ref의 강한 변경 안전성을 남기면서 저장소 전체의 일관성 비용을 완화한 점, push 때 이미 받아 둔 불변 pack을 fetch와 지역 캐시에서 다시 사용한 점, 긴 압축 작업을 비동기로 분리한 점이 기술적으로 중요하다.
OpenAI는 개발 과정에 Rust와 형식 검증 도구를 활용하고, 약 10주 만에 내부 운영 수준으로 발전시켰다고 설명한다. 이 또한 특정 팀의 경험이며, AI가 작성한 서버 코드라면 별도 검증 없이 바로 운영해도 된다는 뜻은 아니다.
관련 움직임으로 OpenAI는 11월 4일 코드 저장·리뷰 도구를 개발하는 Pierre의 인수 계획도 발표했다. 다만 이 발표가 Pando 내부 구조를 증명하거나 Git의 미래 표준을 확정하는 자료는 아니다.
일반적인 개발팀이 이 글에서 가져갈 결론은 명확하다. 먼저 작업 격리와 반복 fetch를 줄여라. 그 다음 측정으로 Git 호스팅의 병목이 확인되면, Pando처럼 변경 가능한 작은 메타데이터와 재사용 가능한 불변 객체의 처리 경로를 나누는 설계를 검토할 수 있다.
댓글
GitHub 계정으로 로그인하면 댓글을 남길 수 있습니다. 댓글은 GitHub Discussions를 통해 운영됩니다.