
기업 현장에서 AI Agent와 대형 언어 모델(LLM)을 도입할 때 가장 큰 난관은 "수많은 비구조화 문서(PDF, 규정집, 학술 논문)를 어떻게 신뢰할 수 있는 지식으로 가공하고, 실제 업무 시스템과 실시간 연동할 것인가"입니다.
단순히 문서를 Vector DB에 저장하고 유사도 검색(Similarity Search)으로 텍스트 조각을 가져오는 기본 RAG(Retrieval-Augmented Generation) 방식은 문서가 복잡해지거나 엔티티 간 정밀한 관계 추론이 필요할 때 할루시네이션(환각)과 맥락 단절의 한계를 드러냅니다.
Palantir의 "Speedrun: Your First AIP Workflow" 코스는 PDF 정보 추출, Ontology, AIP Chatbot과 대화형 앱을 연결합니다. 이 글은 그 학습 경로와 관련된 데이터·로직·화면 설계를 함께 설명합니다.
아래의 데이터 파이프라인, 온톨로지 바인딩, AIP Logic, UI 구성은 연결 구조를 이해하기 위한 예시입니다.
공식 학습 범위와 보충 설계 예시
Palantir의 공식 AIP 시작 안내는 Speedrun: Your First AIP Workflow를 60–90분의 실습 과정으로 설명합니다. 공식 안내에서 확인되는 큰 흐름은 PDF에서 정보 추출 → Foundry Ontology에 데이터 반영 → 지식그래프 기반 AIP Chatbot 구성 → 챗봇을 사용하는 대화형 앱 구축입니다. AIP Chatbot Studio와 Workshop의 AIP Chatbot 위젯은 현재 문서에서 확인할 수 있는 별도 기능입니다.
아래의 9개 모듈 구분은 이 블로그가 학습 요소를 세분화한 설명 목차입니다. 공식 Speedrun 강좌의 모듈 수나 화면 순서와 1:1 대응함을 검증하지 않았습니다. 본문에 제시하는 Chunk, Entity, Join, Vertex, AIP Logic 등의 세부 설계도 공식 60–90분 실습에서 그대로 실행했다는 뜻이 아닙니다.
| 공식 흐름 | 이 글에서 설명하는 대응 요소 | 독자가 실제로 확인해야 할 결과 |
|---|---|---|
| PDF 정보 추출 | Media Set, Pipeline Builder, LLM 추출 | 텍스트·추출 필드·데이터셋 생성 확인 |
| Ontology 구성 | Object Type, Link Type, 관계 모델 | 객체와 연결이 보이고 접근 권한이 맞는지 확인 |
| AIP Chatbot 구성 | 지식그래프 컨텍스트, 도구·함수 경계 | 출처가 있는 답변과 도구 권한을 검증 |
| 대화형 앱 구축 | Workshop 연결 | 앱에서 챗봇을 호출하고 결과를 확인 |
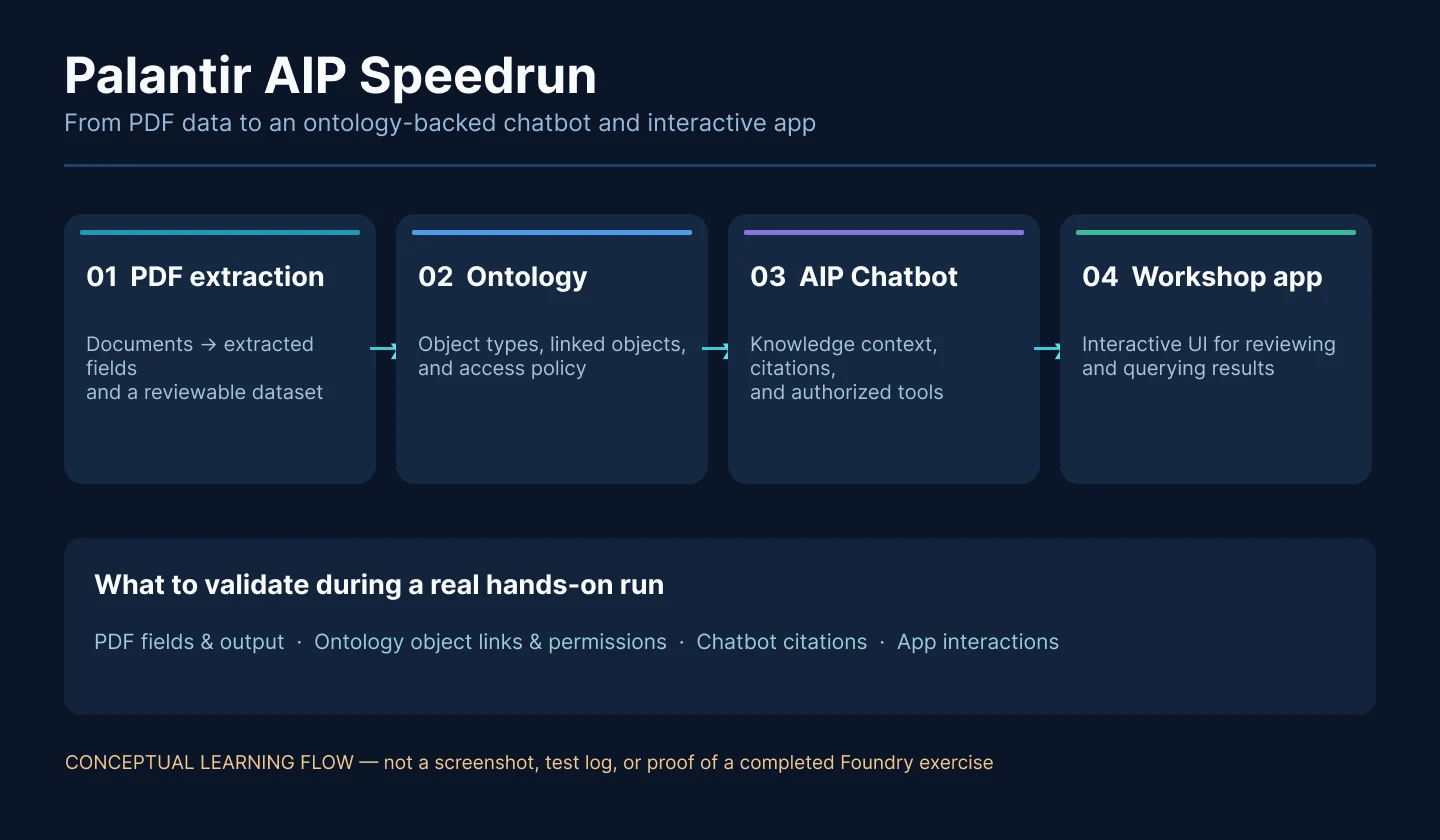
PDF에서 앱으로 이어지는 개념 흐름도입니다. Foundry 실행 화면이 아닙니다.
이 글은 학습 경로와 아키텍처 해설입니다. 재현 가능한 계정 실습 절차는 공식 코스를 따르고, 세부 메뉴와 기능은 계정의 권한·버전에 맞게 확인하세요.
1. 엔드투엔드 파이프라인 아키텍처 (E2E Architecture)
Palantir AIP 시스템은 비구조화 PDF 데이터가 파이프라인을 통과하며 단계적으로 시맨틱 온톨로지 객체로 변환되고, AIP Logic과 Workshop UI를 통해 실시간으로 추론·시각화되는 구조를 가집니다.
전체 연결을 데이터 처리, 온톨로지, 활용 계층으로 나눠 읽습니다. 표의 각 행은 출발 구성에서 도착 구성으로 향하는 연결입니다. 같은 출발점의 여러 행은 분기이며 순차 실행을 뜻하지 않습니다.
데이터 처리와 LLM 배치 추출의 입력·출력은 다음과 같습니다.
| 출발 구성 | 도착 구성 |
|---|---|
| Raw PDF Documents (Media Set) | Pipeline Builder / Data Transformation |
| Pipeline Builder / Data Transformation | Text Chunking & Hash PK Assignment |
| Pipeline Builder / Data Transformation | Vector Embedding Model Integration |
| Pipeline Builder / Data Transformation | LLM Batch Node: Entity Extraction & Resolution |
| Text Chunking & Hash PK Assignment | Chunks Dataset |
| LLM Batch Node: Entity Extraction & Resolution | Entities Dataset |
| Pipeline Builder / Data Transformation | Chunk-Entity Join Table (M:N) |
Palantir Semantic Layer에서 데이터셋과 조인 테이블은 온톨로지의 객체·링크 타입에 대응합니다.
| 데이터 구성 | 온톨로지 구성 |
|---|---|
| Chunks Dataset | Chunk Object Type |
| Entities Dataset | Entity Object Type |
| Chunk-Entity Join Table (M:N) | Object Link Types (Chunk ↔ Entity) |
Analytics & AIP Reasoning Engine은 세 온톨로지 구성 각각을 두 소비자에 연결합니다. 두 소비자는 모두 Workshop UI로 이어집니다.
| 출발 구성 | 도착 구성 |
|---|---|
| Chunk Object Type | Vertex Knowledge Graph Visualizer |
| Entity Object Type | Vertex Knowledge Graph Visualizer |
| Object Link Types (Chunk ↔ Entity) | Vertex Knowledge Graph Visualizer |
| Chunk Object Type | AIP Logic Function (Prompt Studio / TS) |
| Entity Object Type | AIP Logic Function (Prompt Studio / TS) |
| Object Link Types (Chunk ↔ Entity) | AIP Logic Function (Prompt Studio / TS) |
| Vertex Knowledge Graph Visualizer | Workshop Interactive Application UI |
| AIP Logic Function (Prompt Studio / TS) | Workshop Interactive Application UI |
2. 모듈별 구성과 설정 (Module 1 – 9)
Module 1. Course Introduction (유즈케이스 & 목표)
1.1 유즈케이스 배경 및 해결 과제
- 핵심 목표: 사내 전문 라이브러리(PDF 규정집, 학술 논문, 특허 기술 문서 등)에서 필요한 정보와 엔티티 간 연결 관계를 신속하게 추출하고, 근거(Citation)를 갖춘 답변을 제시하는 "디지털 인턴(Summer Intern)" 앱 구축.
- 설계 의도: 문서의 Entity와 Chunk를 그래프로 연결해 관계 맥락과 출처를 제공합니다. 추출 오류나 잘못된 추론은 여전히 가능하므로 답변과 근거의 일치 여부를 검증해야 합니다.
1.2 준비 사항 (Prerequisites)
- 필요한 데이터·Ontology·AIP 기능에 접근할 수 있는 Foundry 계정. 가입 경로와 이용 조건은 공식 안내에서 확인합니다.
Module 2. Setting Up Your Project and Folder (프로젝트 및 폴더 구성)
Foundry 내에서 데이터 자원과 온톨로지 정의가 섞이지 않도록 보안 및 폴더 구조를 철저히 격리합니다.
- Create a Foundry Learning Project:
- Foundry 헤더 메뉴에서
Projects & Files로 이동하여 신규 프로젝트AIP Speedrun - Learning Project를 생성합니다. - 학습용 데이터에 접근할 사용자와 권한을 설정합니다. 폴더를 나누는 것만으로 접근이 격리되지는 않습니다.
- Create Training Folder:
- 프로젝트 내부 하위에
Training_PDF_AIP_Workflow폴더를 마련합니다. - 이 폴더 안에
01_Ingestion,02_Pipeline,03_Ontology,04_AIP_Logic,05_Workshop_App서브 폴더를 구조화합니다.
Module 3. Uploading the Data (원천 데이터 수집)
비구조화 PDF 문서를 파운드리 인프라로 수집(Ingestion)하는 단계입니다.
- Create Media Set:
01_Ingestion폴더에서New -> Media Set을 선택합니다.- 수집할 PDF 파일 세트(예: 수백 페이지 분량의 항공 공학 기술 문서 또는 법률 판례집)를 업로드합니다.
- Media Set 파일 인덱싱:
- Media Set의 PDF를 파이프라인 입력으로 연결합니다. 업로드와 텍스트 추출은 별도 단계입니다. 문서에 따라 원문 텍스트 추출 또는 OCR 변환을 선택합니다.
- [Optional] Deploy via Marketplace:
- 실습 속도를 위해 미리 정제된 레퍼런스 데이터셋 템플릿을 Marketplace에서 일괄 배포(Deploy)하는 옵션도 지원됩니다.
Module 4. Transforming Data & LLM Extraction (데이터 변환 & LLM 개체 파이프라인)
이 설계 예시는 Pipeline Builder에서 비구조화 PDF를 데이터셋 3종(Chunks, Entities, Join Table)으로 변환하는 흐름을 가정합니다.
[Raw Media Set PDF] │ ┌────────┴────────┐ ▼ ▼[Text Chunking] [Embedding Vector] │ │ ▼ │[Chunk Dataset] ◄───────┘ │ ▼[LLM Batch Entity Extraction] │ ├─────────────────┐ ▼ ▼[Entities Dataset] [Join Table (Chunk-Entity M:N)]Step 4.1. Text Chunking (텍스트 조각화)
- PDF 매체 세트에서 텍스트 스트림을 읽어와 일정한 크기의 문맥 단락(Text Chunk)으로 분할합니다.
- 청킹 원칙: 하나의 Chunk는 "단일 정보 포인트(Single Point of Information)"를 온전히 포함하도록 단락/문장 경계를 기준으로 쪼갭니다.
- Chunk ID 부여: 각 Chunk마다 고유한 Primary Key(
chunk_id)를 생성하기 위해 텍스트 내용과 문서명을 조합한 Hash 함수를 적용합니다.
Step 4.2. Vector Embeddings (의미 벡터 인덱싱)
- 분할된 Chunk 텍스트에 임베딩 모델(예: Text Embedding Model)을 실행하여 벡터 차원 필드(
embedding_vector)를 스키마에 추가합니다.
Step 4.3. LLM Batch Entity Extraction (LLM 기반 엔티티 추출)
- Pipeline Builder 내의 LLM Batch Node를 추가하고 프롬프트 스펙을 정의합니다:
Prompt: | 다음 텍스트 조각을 읽고, 등장하는 핵심 엔티티(인물, 조직, 기술 용어, 제품, 장소 등)를 추출하세요. 출력은 JSON 배열 형태여야 하며, 각 엔티티의 이름(entity_name)과 유형(entity_type), 설명(description)을 포함하세요.- Entity Resolution (개체 정규화):
- LLM 처리 결과로 나온 엔티티 표기(예: "Palantir Technologies", "Palantir Corp", "Palantir Inc")를 표준 식별자(
entity_id)로 일관되게 정제하고 중복을 제거합니다.
Step 4.4. Join Table (다대다 연관 테이블) 생성
- Chunk와 Entity 사이의 연결 관계를 표현하는
Chunk_Entity_Join데이터셋을 생성합니다. - 스키마 구조:
join_id,chunk_id,entity_id,extraction_confidence
Step 4.5. Deploy Pipeline
- 전체 노드를 구성한 뒤
Deploy Pipeline을 눌러 Spark 파이프라인을 실행하고 최종 데이터셋 3종을 생성합니다.
Module 5. Configuring Ontology (온톨로지 객체 구성)
파운드리 시맨틱 레이어(Ontology)에 생성된 데이터셋을 매핑하여 business-centric 객체 모델로 전환합니다.
5.1 Chunk Object Type 정의
- Object Type Name:
Chunk - Backing Dataset:
Chunks Dataset - Primary Key:
chunk_id(String) - Title Property:
chunk_id - Properties:
text_content(String): 문서 청크 본문 텍스트source_doc(String): 원본 PDF 파일명embedding_vector(Vector): 의미 검색용 임베딩
5.2 Entity Object Type 정의
- Object Type Name:
Entity - Backing Dataset:
Entities Dataset - Primary Key:
entity_id(String) - Title Property:
entity_name - Properties:
entity_name(String): 엔티티 명칭entity_type(String): 엔티티 카테고리 (Organization, Technology, Person 등)description(String): LLM이 작성한 엔티티 개요
5.3 Object Link Types (M:N 릴레이션 바인딩)
- Link Type Name:
ChunkToEntity/EntityToChunk - Relation Pattern:
Many-to-Many (M:N) - Join Table:
Chunk_Entity_Join데이터셋 매핑 (chunk_id↔entity_id) - 효과: 특정
Entity를 조회했을 때 그 엔티티가 언급된 모든Chunk객체를 즉시 다형성 그래프 탐색(Traverse)할 수 있습니다.
Module 6. Exploring Object Relations (Vertex 지식그래프 시각화)
- Vertex Graph Open: Foundry 메뉴에서
Vertex탐색기를 열고 온톨로지의Entity와Chunk객체를 캔버스에 추가합니다. - Graph Traversal (네트워크 탐색):
- 중심 엔티티 노드(예: "Palantir AIP")를 선택하고
Expand Links를 클릭하면, 해당 엔티티와 연결된 청크 노드들이 펼쳐집니다. - 청크 노드를 통해 또 다른 엔티티 노드(예: "Foundry Ontology", "Workshop")로 네트워크가 이어지는 지식그래프의 시각적 형태를 확인합니다.
- Configure Vertex Template:
- 엔드유저 앱에서 특정 엔티티를 선택했을 때 연관 노드 뷰를 동적으로 시각화해 주는 그래프 템플릿(
Knowledge_Graph_Explorer_Template)으로 저장합니다.
Module 7. Creating an AIP Logic Function (AIP 로직 함수 구현)
Workshop 앱에서 사용할 로직은 AIP Logic에서 구성할 수 있습니다. 아래 입출력과 프롬프트는 개념 예시이며, TypeScript Functions는 별도의 함수 구현 경로입니다.
7.1 AIP Logic 함수 입출력 정의
- Input Parameters:
user_query(String): 사용자의 질의selected_entities(List of Entity): 사용자가 앱에서 선택하거나 검색한 엔티티 객체 목록- Output Return:
response_text(String): 생성된 답변. 출처와의 일치 여부는 별도 검증 필요referenced_chunks(List of Chunk): 근거로 활용된 청크 객체 목록
7.2 Grounded Prompt & Guardrail 작성
System Prompt: | 당신은 Palantir AIP 기반의 전문 지식 분석 에이전트입니다. 사용자의 질문({user_query})에 답할 때, 반드시 제공된 지식그래프 Context 객체들만 바탕으로 답변해야 합니다. [Context Objects] - Related Entities: {selected_entities} - Grounded Chunks: {retrieved_chunks_text} [답변 규칙] 1. 제공된 Context에 없는 내용을 절대 추측하여 답변하지 마세요. (Strict Anti-Hallucination) 2. 문장 끝에는 반드시 근거가 된 Chunk ID를 [Chunk: {chunk_id}] 형태로 분명하게 명시하세요. 3. Context 정보가 부족한 경우 "제시된 지식 기반 내에서는 해당 질문에 답할 수 없습니다."라고 솔직하게 응답하세요.7.3 Function Publish
- 작성한 로직의 단위 테스트를 통과한 후,
Publish Version을 실행하여 프로덕션 아티팩트로 배포합니다.
Module 8. Building an App (Workshop 인터랙티브 앱 제작)
Palantir Workshop 도구를 활용하여 비즈니스 분석가와 엔드유저가 즉시 사용할 수 있는 리액시브 웹 응용프로그램을 구성합니다.
┌─────────────────────────────────────────────────────────────────────────┐│ [Header Bar] AIP Speedrun Knowledge Explorer App │├───────────────────────────────┬─────────────────────────────────────────┤│ [Search & Input Panel] │ [Vertex Graph Component] ││ > Search Entity: "AIP" │ ││ > User Question: "AIP 기능?" │ (Entity: AIP) ─── (Chunk #102) ││ │ │ │ ││ [Object List Panel] │ (Chunk #105) ─── (Entity: Ontology) ││ - Entity: Palantir AIP │ ││ - Chunk #102: "AIP는..." ├─────────────────────────────────────────┤│ - Chunk #105: "Ontology..." │ [AIP Response Panel] ││ │ > "Palantir AIP는 온톨로지 기반으로..." ││ [Button: Run AIP Logic] │ [Source: Chunk #102, #105] │└───────────────────────────────┴─────────────────────────────────────────┘8.1 Workshop 레이아웃 설계
- Left Navigation Panel:
- 엔티티 검색창 및 사용자가 선택한 엔티티/청크 오브젝트 테이블 리스트 컴포넌트 배치.
- Top-Right Main Canvas:
- Vertex Graph Widget: Module 6에서 만든
Knowledge_Graph_Explorer_Template을 내장하여, 좌측에서 선택한 엔티티에 따라 지식그래프 네트워크가 실시간으로 반응하도록 바인딩.
- Bottom-Right Response Panel:
- AIP Response Card: 사용자 질문 입력 박스와
AIP Logic Function호출 버튼, 생성된 답변 및 근거 Chunk 바로가기 딥링크 컴포넌트배치.
8.2 Event & State Binding (상태 연동)
On Search Submit->Filter Entity Objects->Update Vertex Graph Selection->Invoke AIP Logic Function->Render Response & Citation Links.
Module 9. Conclusion & Advanced Patterns (실무 확장 및 보안)
- 학습 목표: PDF 정보가 Ontology와 챗봇을 거쳐 앱에서 사용되는 연결을 이해합니다. 위 보충 설계 전체가 공식 코스의 60–90분 안에 완성된다는 뜻은 아닙니다.
- 실무 운영 시 고려사항 (Production Scale-Up):
- RBAC & Data Governance: 온톨로지 객체 수준에서 사용자 권한(Markings & Role Access)을 적용하여 보안 수준에 따라 특정 청크/엔티티 노드가 조율되도록 제어.
- Incremental Data Pipeline: 신규 PDF 문서가 인제스트될 때 전체 파이프라인을 재실행하지 않고, 신규 추가분만 청킹 및 LLM 추출을 수행하는 증분 파이프라인(Incremental Pipeline) 구성.
3. 핵심 비교: RAG vs GraphRAG vs Palantir Ontology AIP
| 구분 | 기본 RAG (Basic RAG) | GraphRAG | Palantir Foundry AIP |
|---|---|---|---|
| 지식 표현 방식 | 텍스트 조각 (Text Chunk + Vector) | 그래프 노드 & 엣지 (Graph Network) | 온톨로지 객체 모델 (Ontology Object + Links) |
| 추론 방식 | Top-K 유사도 검색 (Similarity Search) | 커뮤니티 요약 및 시맨틱 그래프 탐색 | 지식그래프 + 온톨로지 액션 + AIP Logic |
| 근거 제공 방식 | 검색한 문서 조각 | 그래프 관계와 관련 문서 | 객체·관계와 출처. 답변 정확도는 별도 평가 필요 |
| 엔드유저 앱 연동 | 별도 프론트엔드 개발 필요 | 외부 대시보드 커스텀 개발 필요 | Workshop & Vertex 통합 제공 (No-Code UI) |
| 기업 시스템 연동 | 기본 검색 외의 쓰기는 별도 도구 필요 | 그래프 검색 외의 쓰기는 별도 도구 필요 | Action Types 등으로 쓰기 동작 구성 가능 |
결론 및 엔지니어링 인사이트
위 설계 예시는 추출한 엔티티를 온톨로지 객체로 연결한 뒤, 검색과 로직 함수에서 사용하고 Workshop 화면에 표시합니다. 각 단계의 출력이 다음 단계의 어떤 입력이 되는지 확인하며 읽으면 됩니다.
- 비구조화 데이터의 시맨틱 자산화: PDF 문서가 단순 파일로 남지 않고
Chunk와Entity라는 온톨로지 객체로 재구성됩니다. - 지식그래프를 통한 명확한 맥락 제공: LLM이 관계를 오해하지 않도록 Vertex 지식그래프 기반의 풍부한 맥락을 주입합니다.
- 운영 정책으로 제어하는 AI 워크플로우: AIP Logic과 Workshop UI를 연동해 보안, 근거 제시, 반응형 UI를 갖춘 기업용 AI 애플리케이션을 구성할 수 있습니다.
댓글
GitHub 계정으로 로그인하면 댓글을 남길 수 있습니다. 댓글은 GitHub Discussions를 통해 운영됩니다.